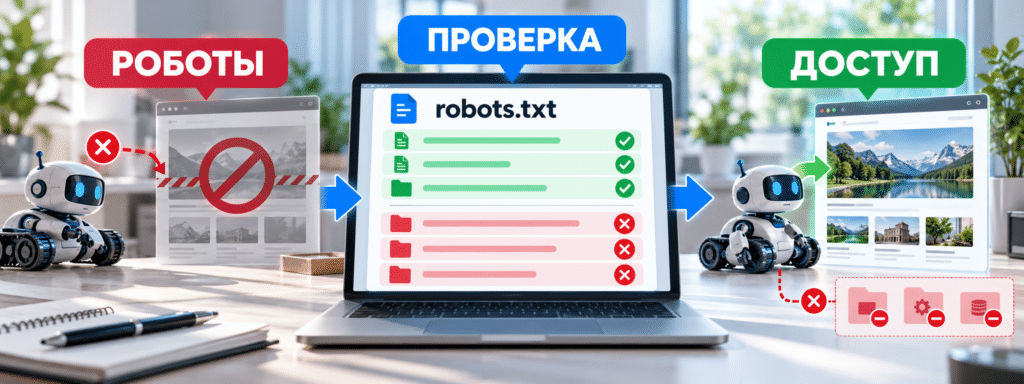
Представьте: сайт работает, контент на месте, а из поиска пропали все страницы. Или наоборот — в индексе висят служебные файлы и корзины, которые там быть не должны. Или реклама крутится, а трафика нет, и никто не понимает почему. Причина в одном маленьком файле, который никто не открывает годами: robots.txt. Одна строка в нём может стоить бизнесу недель трафика, и заметить это по внешнему виду сайта невозможно.
Разберём не «что такое robots.txt», а конкретные ситуации, в которых он вредит, — и что проверить в каждой.
Ситуация 1. Сайт закрыт от индексации целиком
Самая частая и самая дорогая ошибка. Файл содержит Disallow: / — и поисковик не обходит ни одну страницу. Иногда это оставили после разработки на тестовой копии и забыли снять. Иногда кто-то «на всякий случай» закрыл сайт и ушёл в отпуск.
Что проверить: откройте ваш-сайт.ru/robots.txt и посмотрите на строки с Disallow. Если там стоит одиночный слэш без уточнений — это полный запрет. Заодно проверьте, не закрыт ли сайт ещё и в настройках WordPress: там есть отдельная галочка «Попросить поисковые системы не индексировать сайт». Два запрета друг друга не отменяют, а складываются.
Как убедиться: откройте сайт через инструмент проверки URL в Search Console. Он покажет, разрешён ли обход. Если «заблокировано robots.txt» — вот и ответ.
Ситуация 2. Закрыто то, что приносит трафик
Более коварный вариант. Сайт открыт, но под запрет попали разделы, которые должны ранжироваться: каталог, статьи блога, страницы услуг. Часто это следствие «оптимизации»: кто-то решил, что пагинация, фильтры или теги мешают, и закрыл их целиком — вместе с полезными страницами.
Что проверить: пройдитесь по строкам Disallow и для каждой ответьте на вопрос: «есть ли на этих страницах то, что должно находиться в поиске?» Если да — правило лишнее.
Отдельно проверьте адреса с параметрами. Запрет вроде Disallow: /*?* закрывает всё, где есть знак вопроса, — включая страницы, которые вы, возможно, хотите показывать. А правила с ?, * и $ работают по-разному в разных поисковиках, и лишняя звёздочка меняет смысл.
Как убедиться: возьмите пять-семь адресов, которые точно должны быть в поиске, и проверьте их через инструмент проверки URL. Не на глаз, а именно проверкой.
Ситуация 3. В индексе висит мусор
Обратная проблема. Сайт открыт, но поисковик обходит и индексирует то, что не нужно: корзину, личный кабинет, страницы поиска, результаты фильтров, административные адреса. Это размывает вес между страницами и создаёт дубли.
Что проверить: убедитесь, что в файле есть правила для служебных разделов. Минимум, который стоит закрыть, — /wp-admin/, /cart/, /checkout/, /my-account/, /search/ и адреса с результатами фильтров. Но помните: robots.txt запрещает обход, а не индексацию. Если на страницу уже ведут ссылки, она может остаться в выдаче без описания.
Как убедиться: посмотрите в Search Console, какие страницы реально попали в индекс. Если там корзины и фильтры — либо добавьте правила в robots.txt, либо закройте эти страницы от индексации через мета-тег noindex (что надёжнее), а запрет в robots.txt используйте как дополнение, а не как основное средство.
Ситуация 4. Файл есть, но его не читают
Бывает, что правила написаны правильно, а результата нет. Причины обычно две. Первая — файл недоступен по стандартному адресу: отдаёт ошибку, редирект или другой код ответа. Вторая — синтаксис: опечатка в слове Disallow, лишние пробелы, неверная кодировка, комментарий не с той стороны строки.
Что проверить: откройте адрес файла в браузере и убедитесь, что он открывается как обычный текст, а не как страница 404. Затем проверьте синтаксис: каждая директива начинается с новой строки, пишется с заглавной буквы и двоеточия. Комментарии начинаются с # и стоят отдельно.
И не забывайте, что robots.txt — это ещё и указание на карту сайта. Строка Sitemap: с полным адресом помогает поисковику быстрее найти страницы. Если её нет или адрес неверный, это не ошибка, но полезная вещь теряется.
Ситуация 5. Разные правила для разных поисковиков
Иногда в файле несколько блоков User-agent, и они противоречат друг другу. Например, общий блок разрешает всё, а блок для конкретного бота что-то закрывает. Поисковики выбирают самый релевантный блок и игнорируют остальные — но не всегда очевидно, какой именно.
Что проверить: убедитесь, что для каждого User-agent правила не конфликтуют. Если вы хотите закрыть что-то только для одного бота, проверьте, что общий блок не открывает это же самое. И помните: правила применяются к самому конкретному совпадению, а не суммируются.
Отдельно — AI-краулеры. В 2026 году многие сайты сознательно закрывают GPTBot, ClaudeBot или PerplexityBot. Решение спорное, но если вы его приняли, проверьте, что запрет действительно работает и не задевает обычные поисковики.
Как проверить всё за пятнадцать минут
- Откройте файл по адресу и прочитайте его целиком — он редко бывает длинным.
- Проверьте, нет ли полного запрета
Disallow: /без причины. - Возьмите пять ключевых страниц и проверьте каждую через инструмент проверки URL.
- Посмотрите в Search Console, что реально попало в индекс — нет ли там корзин и фильтров.
- Убедитесь, что в файле указана карта сайта и её адрес верный.
- Проверьте, нет ли противоречий между блоками для разных User-agent.
Этого достаточно, чтобы поймать почти все серьёзные проблемы. Если сайт большой, добавьте проверку разделов: каталог, блог, услуги — по одному адресу из каждого.
Красные флаги
- В файле стоит
Disallow: /, и никто не помнит, зачем. - Под запрет попали страницы, которые должны ранжироваться.
- В индексе висят корзины, поиск и результаты фильтров.
- Файл открывается с ошибкой или редиректом.
- В директивах опечатки или неверная кодировка.
- Разные блоки User-agent противоречат друг другу.
- Файл меняли, но не проверяли результат.
Что в итоге
robots.txt — маленький файл с большими последствиями. Одна строка может закрыть сайт от поиска или, наоборот, открыть то, что нужно спрятать. Проверить его стоит не после падения трафика, а заранее — и каждый раз, когда меняется структура сайта или настройки SEO. Пятнадцать минут раз в несколько месяцев дешевле, чем недели восстановления позиций.
Мы обычно проверяем robots.txt вместе с остальной технической базой: смотрим, что закрыто, что открыто, и совпадает ли это с тем, что реально должно быть в поиске. Иногда достаточно убрать одну строку, иногда — переписать файл под новую структуру. Напишите или оставьте заявку — посмотрим на ваш robots.txt и скажем, что стоит поправить, чтобы поисковик видел именно то, что нужно.